Visão geral
A página inicial (Monitoramento › Visão geral) resume o ambiente em uma tela.
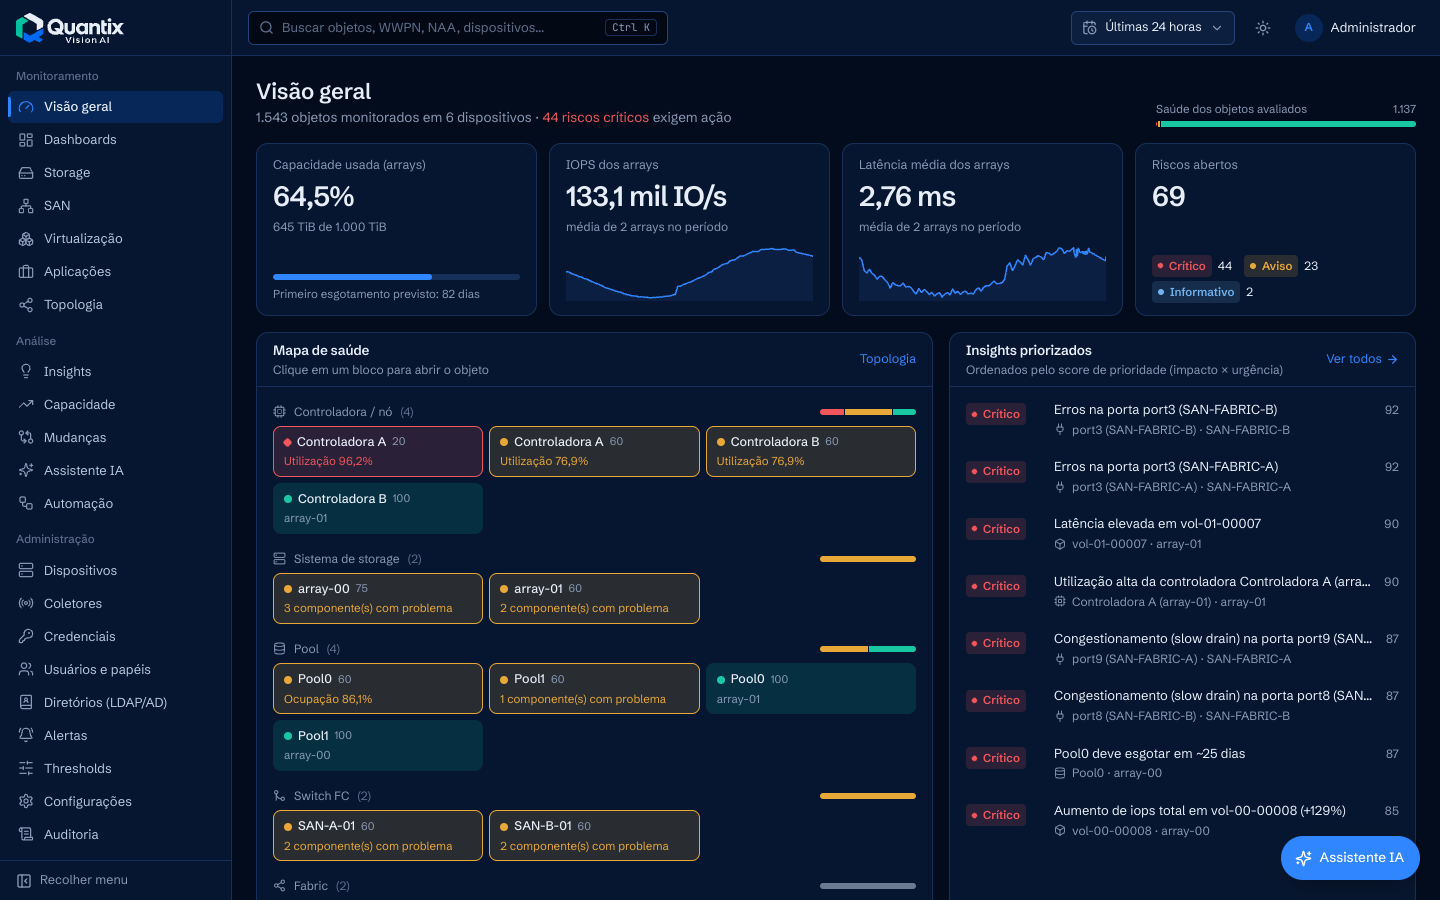
| Bloco | Conteúdo | Clique leva a |
|---|---|---|
| Cabeçalho | objetos monitorados, dispositivos e riscos críticos; barra de saúde dos objetos avaliados | — |
| Capacidade usada (arrays) | soma de usado/total dos sistemas de storage com previsão, e o primeiro esgotamento previsto | Capacidade |
| IOPS dos arrays / Latência média dos arrays | valor agregado no período com sparkline | Storage |
| Riscos abertos | achados abertos por severidade | Insights |
| Mapa de saúde | blocos por objeto (switches FC, sistemas de storage, pools, controladoras, fabrics…), com o score e o principal problema | página do objeto |
| Insights priorizados | achados abertos ordenados pela prioridade (impacto × urgência) | detalhe do insight |
| Riscos de capacidade | objetos mais próximos do esgotamento | Capacidade |
| Mudanças recentes de configuração | últimas alterações detectadas entre inventários | Mudanças |
| Coleta de dados | estado dos dispositivos e coletores | Dispositivos |
Por que um array aparece em aviso com tudo verde?
A saúde de um sistema considera seus componentes: uma controladora ou porta com problema coloca o sistema em aviso (“N componente(s) com problema”). Abra o objeto e use a aba Componentes para ver qual é.
Logo após a instalação, os blocos de saúde e insights aparecem vazios até o primeiro ciclo de performance (poucos minutos). Previsões exigem pelo menos 5 dias de histórico e change detection pelo menos 3 dias.