Insights
Insights é a lista de achados da engine: riscos e anomalias detectados automaticamente, com explicação, evidências e recomendação, priorizados por impacto e urgência.
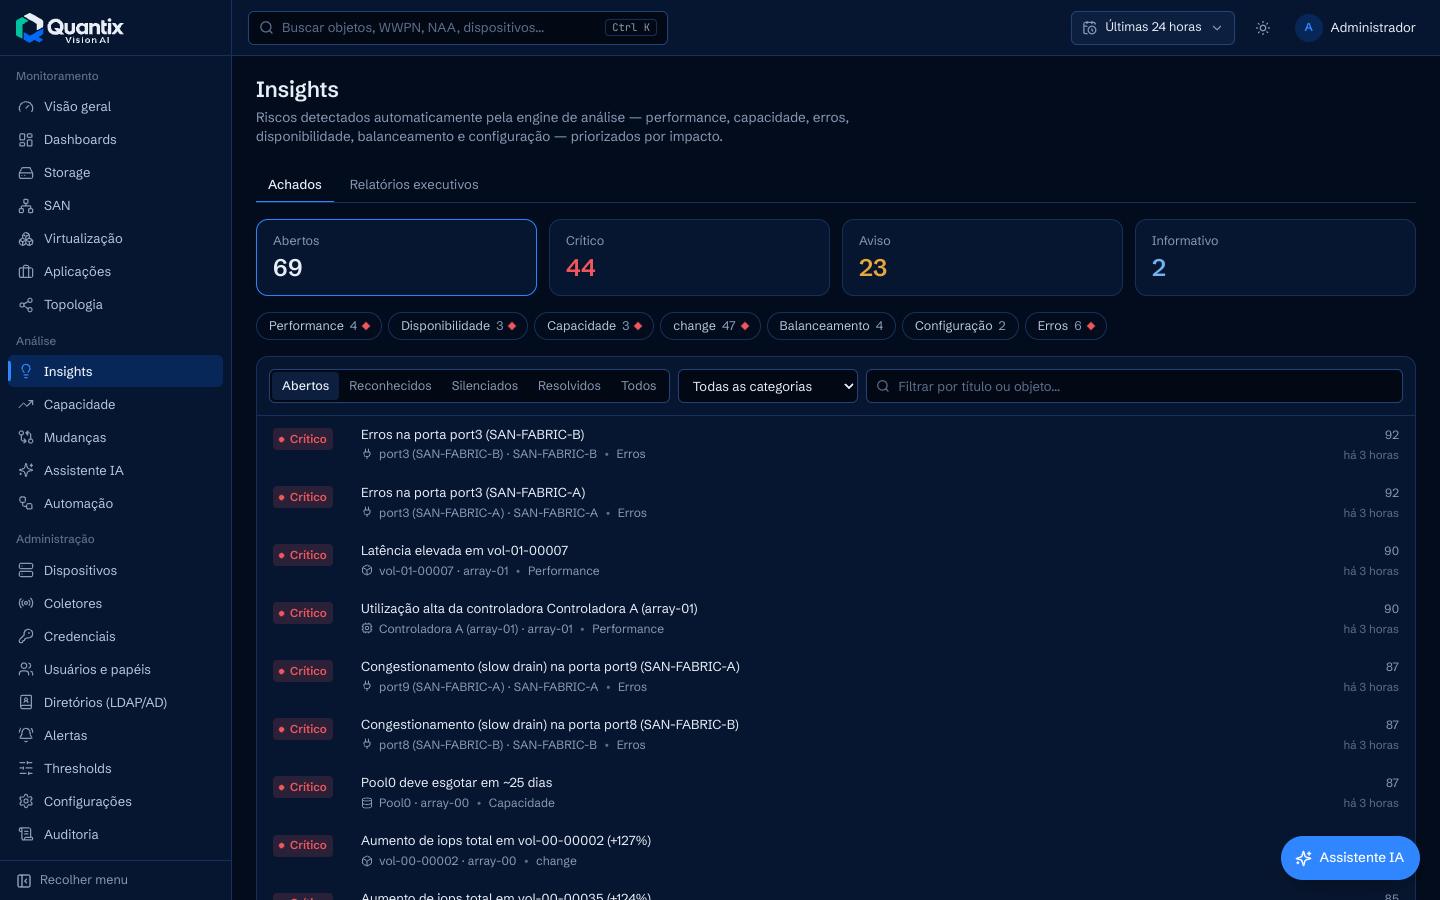
Categorias
| Categoria | Exemplos de regras | Origem |
|---|---|---|
| Performance | latência elevada, utilização alta de controladora/porta, CPU ready, CPU/memória de hosts | ratings (a cada 5 min) |
| Capacidade | ocupação acima do limite, esgotamento previsto | ratings / previsão (6 h) |
| Erros | erros CRC/enc-out/link na porta, congestionamento (slow drain) | ratings |
| Disponibilidade | host ou hipervisor em um único fabric, datastore com caminho único, atraso de replicação, mapeamento sem login | regras de configuração / ratings |
Mudança (change) |
aumento/queda estatisticamente significativa de IOPS, latência, MB/s ou CPU vs. a mesma hora dos últimos 14 dias | change detection (1 h) |
| Balanceamento | carga desbalanceada entre controladoras, portas front-end ou hipervisores | balanceamento (1 h) |
| Configuração | volumes órfãos, zonas mortas, login sem zona, zoning assimétrico | regras de configuração (15 min) |
A lista completa, com condições e severidades, está em Regras da engine.
Severidade e prioridade
- Severidade: Crítico, Aviso ou Informativo, conforme os limites da regra.
- Prioridade (0–100), mostrada à direita de cada item: combina severidade, categoria (disponibilidade e erros pesam mais), magnitude do desvio e a criticidade das aplicações que contêm o objeto. Fórmula em Engine.
Filtros
Contadores por severidade (clique para filtrar), chips por categoria, estado (Abertos, Reconhecidos, Silenciados, Resolvidos, Todos), categoria e texto (título ou objeto).
Detalhe do achado
Clique em um item para abrir o painel lateral:
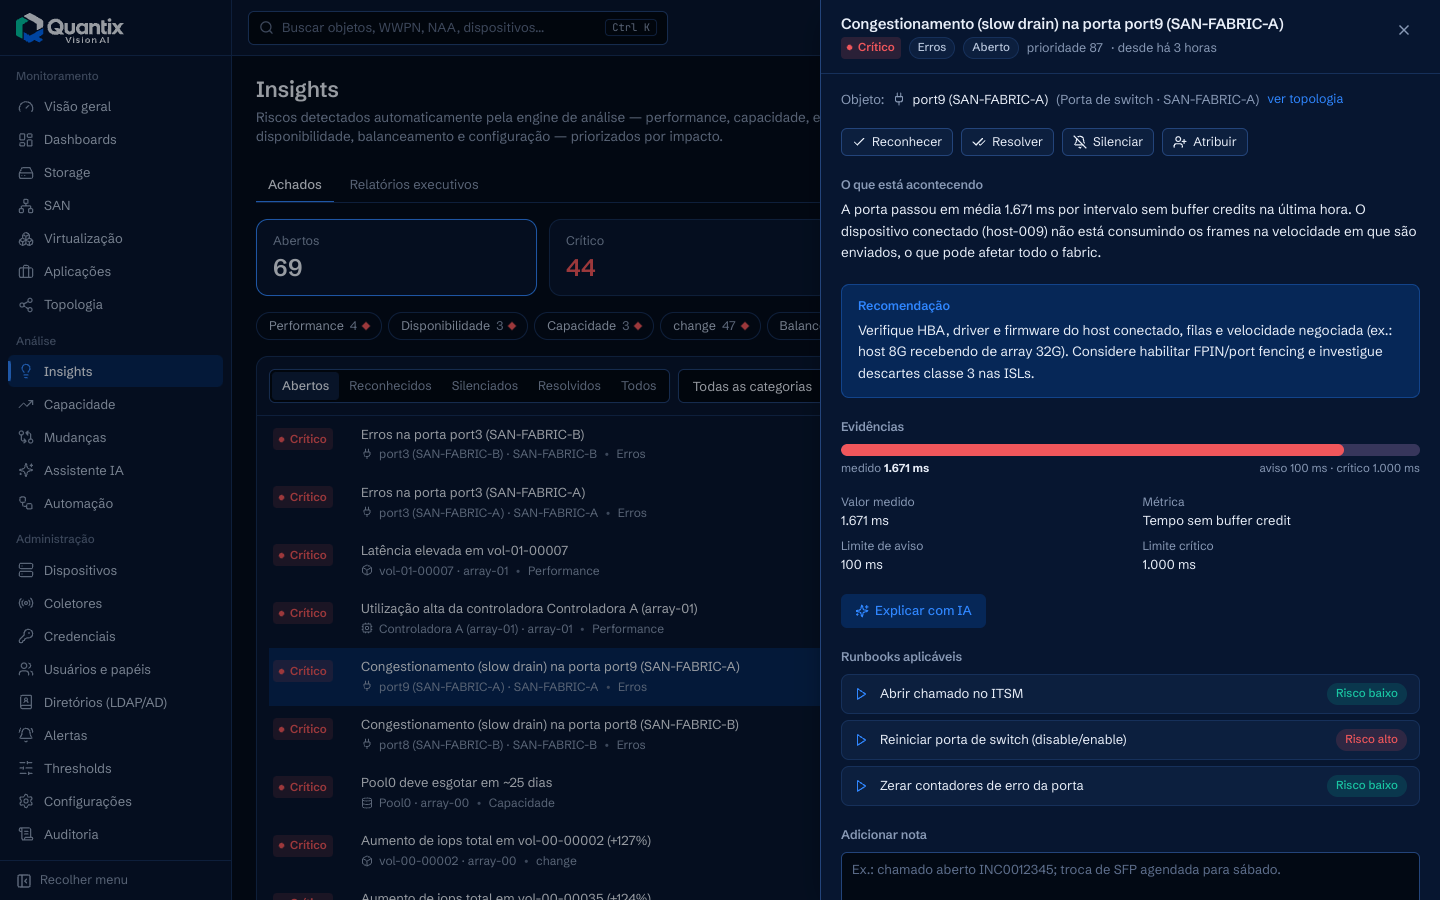
| Seção | Conteúdo |
|---|---|
| Cabeçalho | severidade, categoria, estado, prioridade, desde quando |
| Objeto | link para o objeto e ver topologia |
| O que está acontecendo | descrição com os números medidos e o período |
| Recomendação | próximos passos concretos para aquele tipo de problema |
| Evidências | barra do valor medido contra os limites de aviso/crítico, participação de cada membro (balanceamento), previsão (capacidade), desvio robusto e linha de base (mudança) |
| Explicar com IA | análise de causa provável e plano de ação gerados pelo assistente (se a IA estiver habilitada; senão mostra o texto da engine). A explicação fica guardada até o achado mudar |
| Runbooks aplicáveis | runbooks compatíveis com o tipo do objeto, mais os genéricos (ex.: Abrir chamado no ITSM), com o nível de risco |
| Adicionar nota | histórico de notas (ex.: número do chamado). Execuções de runbook bem-sucedidas também adicionam nota |
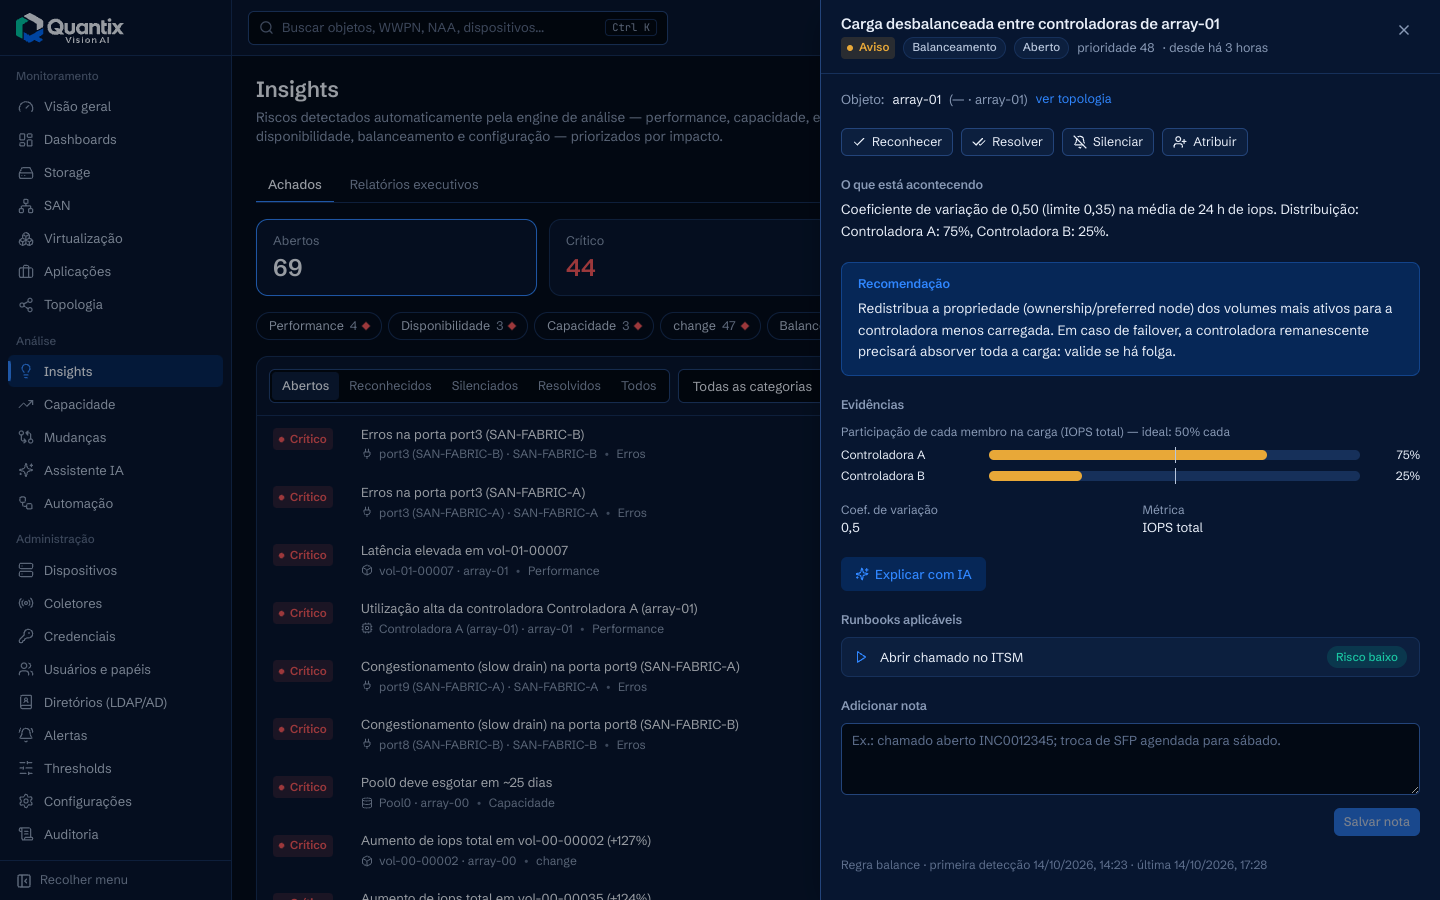
Ações (permissão findings.manage)
| Ação | Efeito |
|---|---|
| Reconhecer | indica que alguém está tratando. Continua sendo atualizado e pode ser resolvido automaticamente |
| Resolver | encerra manualmente. Se o problema persistir, a engine reabre o achado na próxima execução |
| Silenciar | oculta da lista de abertos e nunca é resolvido automaticamente. Use para riscos aceitos |
| Reabrir | volta para aberto |
| Atribuir | define um responsável (usuário ou equipe) |
Resolução automática
Um achado aberto ou reconhecido que não aparece em 2 execuções seguidas da regra é marcado como resolvido automaticamente. Se voltar a ocorrer, reabre com nova data de início. Se a severidade subir, uma nova notificação é enviada mesmo dentro da janela de deduplicação.
Relatórios executivos
A aba Relatórios executivos guarda o resumo diário (gerado a partir de
ai.daily_summary_hour, padrão 7h): riscos críticos e avisos, novos e resolvidos em 24 h, saúde
dos sistemas, as 10 prioridades e os riscos de capacidade. Com IA habilitada, o texto é redigido
pelo assistente para a gestão de TI.